Czym jest regresja liniowa? Wyjaśnienie pojęć i zastosowań
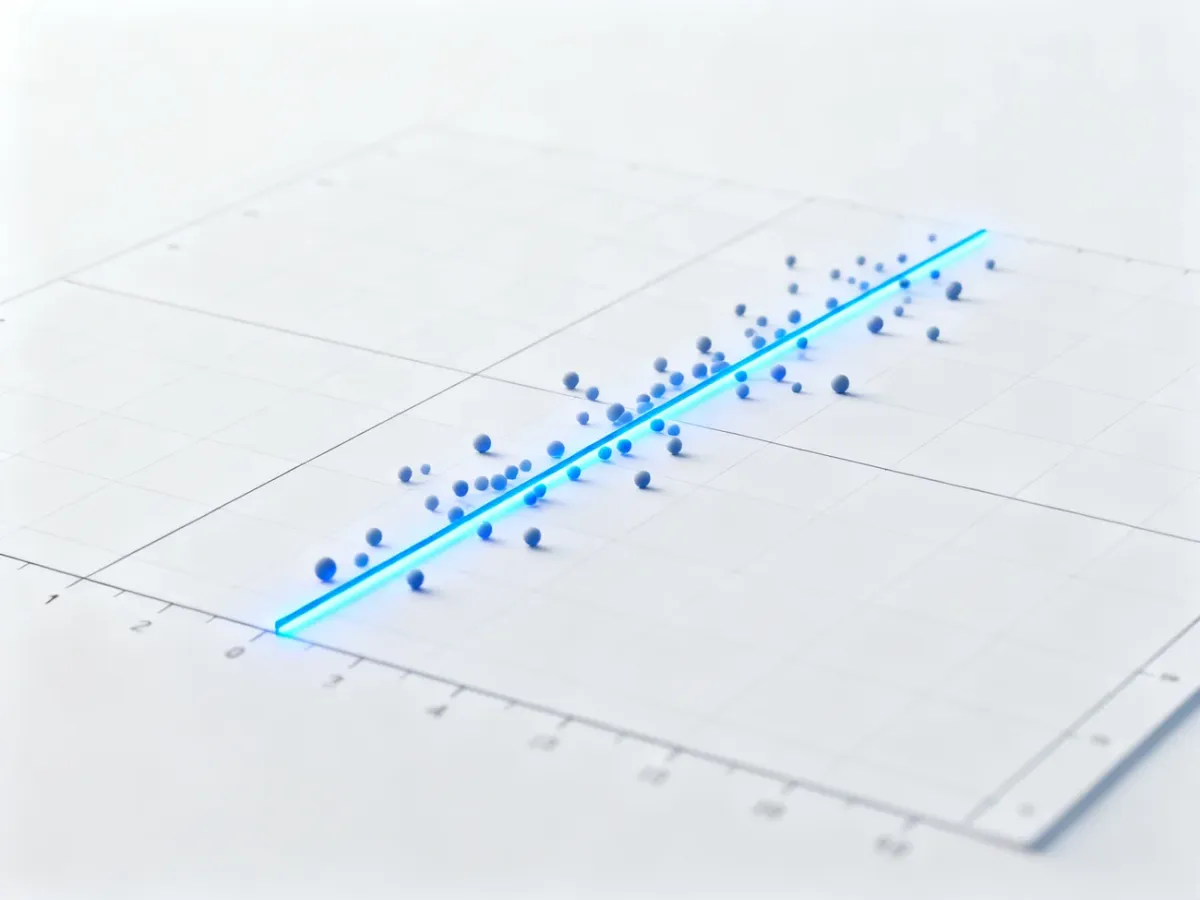
Regresja liniowa to metoda statystyczna służąca do badania zależności między zmiennymi numerycznymi. Pozwala przewidywać wartość jednej zmiennej na podstawie innych, dopasowując do danych linię najlepszego dopasowania.
Czym jest regresja liniowa?
W modelu regresji wyróżnia się zmienną zależną, czyli wynik, który chcemy wyjaśnić lub przewidzieć, oraz jedną albo więcej zmiennych niezależnych, nazywanych także predyktorami. Przykładowo zmienną zależną może być spalanie samochodu, a zmienną niezależną jego masa.
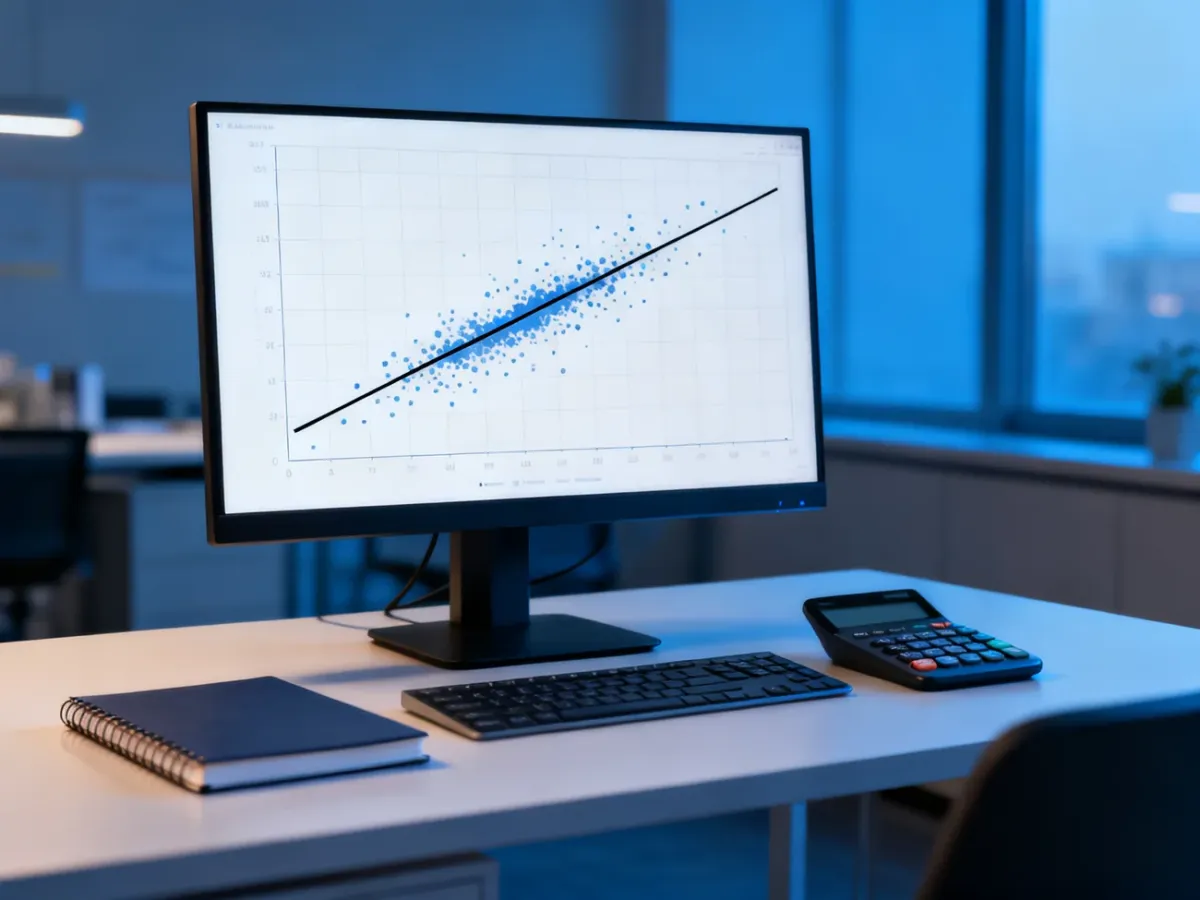
Po naniesieniu obserwacji na wykres otrzymujemy punkty. Regresja liniowa szuka takiej prostej, która możliwie dobrze opisuje ich ogólny kierunek. Jeśli cięższe samochody zwykle zużywają więcej paliwa, nachylenie prostej będzie wskazywało dodatnią zależność. Gdy wraz ze wzrostem jednej cechy druga maleje, nachylenie będzie ujemne.
Model może służyć do prognozowania, ale także do oceny, jak zmiana predyktora wiąże się ze zmianą wyniku. Nie oznacza to automatycznie związku przyczynowego. Regresja opisuje zależność w danych, a interpretacja przyczyn wymaga dodatkowej wiedzy i odpowiedniego projektu badania.
Jak działa linia najlepszego dopasowania?
W najprostszym przypadku model zapisuje się równaniem:
y = ax + b
Poszczególne symbole oznaczają:
- y – przewidywaną wartość zmiennej zależnej,
- x – wartość zmiennej niezależnej,
- a – współczynnik kierunkowy, który opisuje nachylenie prostej,
- b – wyraz wolny, czyli punkt przecięcia prostej z osią y.
W zapisie statystycznym często stosuje się formę y = β0 + β1x + ε. Parametr β0 odpowiada wyrazowi wolnemu, β1 określa zmianę przewidywanego y przy wzroście x o jedną jednostkę, a ε oznacza losowy błąd lub szum.
Punkty nie leżą zwykle idealnie na jednej prostej. Różnica między wartością rzeczywistą a wartością przewidzianą przez model to reszta. Linia najlepszego dopasowania jest wybierana tak, aby suma kwadratów tych różnic była możliwie mała. Ten sposób wyznaczania parametrów nazywa się metodą najmniejszych kwadratów.
Kwadratowanie sprawia, że większe błędy mają większy wpływ na wynik niż małe odchylenia. Dzięki temu model szuka prostej, która nie tylko przechodzi przez środek danych, lecz także ogranicza łączny rozmiar błędów prognoz.
W praktyce proces budowania modelu można ująć w kilku krokach:
- Określa się zmienną zależną i potencjalne predyktory.
- Zbiera się dane oraz sprawdza ich jakość i kompletność.
- Dopasowuje się parametry modelu, najczęściej metodą najmniejszych kwadratów.
- Ocenia się dopasowanie, reszty i spełnienie założeń.
- Używa się modelu do interpretacji lub prognoz, uwzględniając jego ograniczenia.
Regresja prosta i wieloraka – czym się różnią?
Regresja prosta wykorzystuje jeden predyktor. Przykładem jest przewidywanie spalania wyłącznie na podstawie masy samochodu. Regresja wieloraka uwzględnia kilka zmiennych niezależnych jednocześnie, na przykład masę, pojemność silnika, moc i liczbę cylindrów.
W regresji wielorakiej współczynnik przy danym predyktorze interpretuje się jako zmianę przewidywanego wyniku przy zmianie tej zmiennej, przy pozostałych predyktorach utrzymanych na stałym poziomie. Taka interpretacja wymaga ostrożności, zwłaszcza gdy zmienne są ze sobą silnie powiązane.
Przykładowe zastosowania regresji liniowej obejmują:
- prognozowanie sprzedaży na podstawie wydatków reklamowych i sezonowości,
- analizę cen nieruchomości z uwzględnieniem powierzchni, lokalizacji i liczby pokoi,
- ocenę związku między dietą, aktywnością fizyczną a masą ciała,
- prognozowanie wybranych wielkości finansowych, takich jak ceny lub kursy,
- badanie wpływu warunków środowiskowych na wyniki pomiarów naukowych.
Założenia i ograniczenia regresji liniowej
Regresja liniowa jest szybka i łatwa do interpretacji, ale nie pasuje do każdych danych. Przed wyciągnięciem wniosków trzeba sprawdzić, czy model ma sens w danym problemie.
Najważniejsze założenia obejmują:
- Liniowość – zależność między wynikiem a predyktorami powinna być w przybliżeniu liniowa.
- Niezależność obserwacji – jedna obserwacja nie powinna wpływać na błąd innej, co ma szczególne znaczenie przy danych czasowych.
- Homoskedastyczność – wariancja reszt powinna być podobna w całym zakresie przewidywanych wartości.
- Brak silnej współliniowości – predyktory nie powinny być niemal powieleniem tych samych informacji.
- Brak nadmiernego wpływu wartości odstających – pojedyncze nietypowe obserwacje nie powinny całkowicie zmieniać parametrów modelu.
Jeśli dane mają wyraźnie zakrzywiony trend, prosta może dawać systematycznie błędne prognozy. Wartości odstające mogą z kolei przesunąć linię w swoją stronę. Sama wysoka zgodność modelu z danymi nie dowodzi też, że predyktor powoduje zmianę wyniku.
Regresja liniowa a inne testy statystyczne
Regresja liniowa jest częścią szerszej klasy modeli liniowych. Wiele klasycznych testów można zapisać jako szczególne przypadki takiego modelu, choć ich nazwy i sposób prezentacji bywają inne.
| Nazwa testu | Równoważny model liniowy | Opis słowny |
|---|---|---|
| Test t-Studenta | Model z jednym predyktorem lub zmienną grupującą | Sprawdza, czy średnia albo różnica średnich różni się od wartości odniesienia. |
| ANOVA | Model z predyktorami wskazującymi grupy | Porównuje średnie kilku grup w ramach jednego modelu. |
| Korelacja Pearsona | Regresja prosta ze zmienną zależną i jednym predyktorem | Opisuje siłę i kierunek liniowej zależności między dwiema zmiennymi. |
To powiązanie pozwala analizować dane w jednolity sposób. Model dostarcza nie tylko samej prostej, ale też współczynników, błędów standardowych, reszt i miar dopasowania, takich jak R2. Warto jednak pamiętać, że dobry model statystyczny wymaga sprawdzenia założeń, a nie tylko odczytania jednej liczby.
Regresja liniowa sprawdza się jako pierwsze przybliżenie zależności i narzędzie prognozowania. Jej siłą jest prostota, lecz wiarygodność wyników zależy od jakości danych, liniowego charakteru zależności i kontroli wartości odstających.